Anuncio de las actualizaciones del model router en Foundry Models (fuente: techcommunity.microsoft.com)
Lo que se movió en agosto
Tres cosas, y ninguna obliga a tocar código. La primera es el pool: entran Claude Opus 4.8 razonamiento complejo y generación larga y la familia GPT-5.6. Y salen cuatro: gpt-5-chat, gpt-5.2-chat, gpt-5.3-chat y Deepseek-V3.1, deprecados en Foundry al llegar a fin de ciclo de vida. La poda escuece menos cuando es el router quien sustituye por ti.
La segunda son las regiones. El post hablaba de 28 para Global Standard y 21 para Data Zone Standard; la tabla de la documentación, con fecha 1 de septiembre de 2026, ya lista 32 y 23. Dos semanas, cuatro regiones más. No es una contradicción: esto se mueve rápido, así que conviene mirar la tabla oficial antes de prometerle una región a nadie. Detrás hay organizaciones que necesitan que la inferencia no salga de una frontera concreta.
Y la tercera, la que más tranquilidad da en producción: el endpoint es estable. Las actualizaciones ocurren solas y no cambia cuando se refresca el pool, así que no hay que volver a desplegar nada ni tocar la integración. Aun así conviene vigilar las trazas de enrutamiento: calidad, coste, latencia y gobierno.
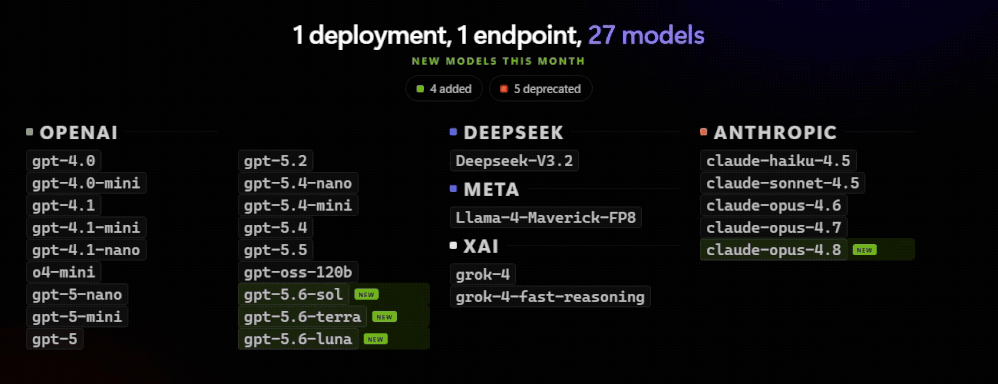
Un despliegue, un endpoint, 27 modelos: el pool tras la actualización, con los recién llegados marcados como NEW (fuente: techcommunity.microsoft.com)
El asterisco de Anthropic
Hay una excepción que conviene grabarse: los modelos de Anthropic siguen necesitando su propio despliegue antes de que el router pueda enrutar hacia ellos. Y si los metes en routing.models sin desplegarlos antes en la misma cuenta de Foundry y con SKU coincidente, la petición no falla en silencio: revienta con InvalidResourceProperties. El troubleshooting oficial lo recoge desde el otro lado: «los modelos Claude no se enrutan».
Versiones que se actualizan en sitio
Este es el detalle que más gente pasa por alto. El model router se versiona por fecha, y la 2025-11-18 es la latest: está activa, así que recibe modelos y funcionalidades nuevas sin que cambie el identificador. Las anteriores, 2025-08-07 y 2025-05-19, están congeladas. Ahí ya no entra nadie.
O sea que no hace falta esperar a un número de versión nuevo para tener modelos nuevos: basta con estar en latest. La letra pequeña está en la casilla de Auto-update, que al actualizar el despliegue cambia el conjunto de modelos subyacentes y puede mover rendimiento y costes. Decisión consciente, no check por inercia.
Un ejemplo de lo que se gana estando en la versión viva: reasoning_effort pasó a estar soportado desde 2025-11-18. Si el router elige un modelo de razonamiento, usa tu valor con el modelo subyacente. Antes, ni eso.
El hill climb, pero en la capa de selección
Microsoft usa «hill climbing» para describir cómo progresa de verdad la IA: no un salto, sino un bucle disciplinado de más cómputo, mejores datos y evaluación más afinada. En el reinforcement fine-tuning es mejorar el paquete desplegable paso a paso. El post lleva la misma idea a la capa que decide qué modelo atiende cada petición.
Y el diagnóstico que hace de cómo elegimos modelo hoy resulta incómodo por lo acertado: a mano, o con routers caseros, tirando de benchmarks, de familiaridad o del último lanzamiento con titulares. Después nadie revisa esa decisión hasta que algo se rompe. Con la frontera moviéndose cada mes, la elección caduca sola aunque el código siga funcionando.
En esta capa, un «paso» es una decisión de enrutamiento. Y como toda respuesta incluye el campo model con el modelo elegido, la escalada deja rastro auditable. Tres patrones:
- A/B testing. ¿Qué modelo o estrategia uso en producción? Mandas tráfico representativo a despliegues que compiten entre sí y comparas calidad, coste, latencia y gobierno antes de promocionar nada.
- Model decomposition. El router como diagnóstico: lo despliegas y miras la telemetría para ver cómo las peticiones se separan solas en clases de tarea. Recuperación, clasificación y resumen caen en modelos pequeños; razonamiento y flujos agénticos piden modelos capaces. No para coronar a un ganador, sino para entender qué hace de verdad tu aplicación.
- Route continuously. ¿Por qué elegir uno? Dejas el router en producción y sigues con el mismo endpoint mientras el pool, las regiones y las capacidades evolucionan.
De los tres, el infravalorado es el segundo. Casi todo el mundo llega buscando ahorro y se queda ahí, sin mirar el mapa de su propia carga que el enrutamiento le dibuja gratis.
Modos de enrutamiento y model subset
Balanced es el modo por defecto: de todos los modelos dentro de una banda de calidad estrecha 1-2 % respecto al mejor para ese prompt elige el más barato. Cost abre la banda a un 5-6 %: clasificación de contenido, preguntas sencillas, mucho volumen. Quality se olvida del precio: revisión legal, resúmenes médicos, razonamiento complejo.
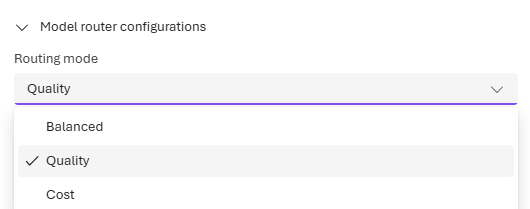
Selección del routing mode al configurar el despliegue (fuente: learn.microsoft.com)
Un aviso que ahorra sustos: los cambios de routing mode tardan hasta cinco minutos en aplicarse. Los de model subset, también. Si tocas la configuración y lanzas la prueba acto seguido, no estás midiendo lo que crees estar midiendo.
El model subset limita qué modelos entran en la decisión. Funciona sorprendentemente bien como puerta de cumplimiento: seguridad aprueba la lista, tú la codificas y los modelos nuevos ya no aparecen sin un opt-in explícito. La contrapartida es la misma moneda por el otro lado: tampoco entran solos los que sí querrías.
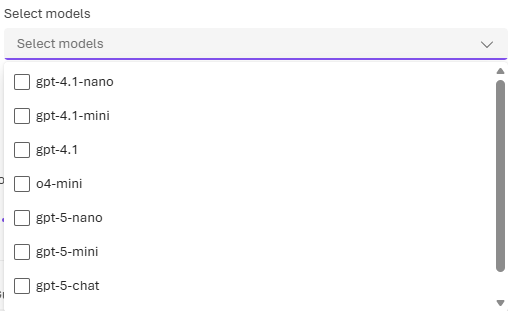
Selección del subconjunto de modelos que participan en el enrutamiento (fuente: learn.microsoft.com)
Lo que no hay que hacer es dejar un subset de un solo modelo. Pierdes optimización, ahorro y failover de golpe, y la documentación lo llama «passthrough caro». No se me ocurre mejor forma de decirlo. Con dos ya tienes red: el failover viene activado por defecto y tu subset actúa además como conjunto de respaldo.
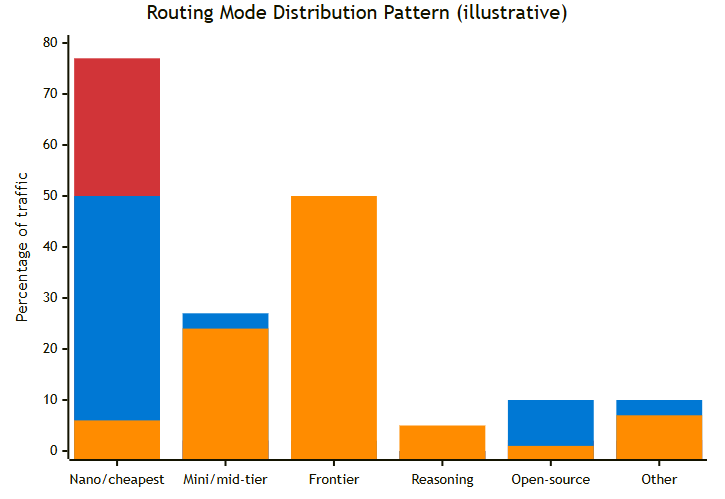
Distribución del tráfico entre niveles de modelo según el modo de enrutamiento (fuente: learn.microsoft.com). El propio documento avisa de que corresponde a un experimento puntual y de que la distribución real varía
Desplegarlo sin pasar por el portal
En el portal es un clic en model-router y Default settings, que te deja en Balanced enrutando entre todos los modelos soportados. Para el resto está la API de gestión, que ni siquiera necesita un proyecto de Foundry: apunta directa a la cuenta. Con modo y subset:
export AZURE_AI_AUTH_TOKEN=$(az account get-access-token \
–resource https://management.azure.com –query accessToken -o tsv)
curl -X PUT «https://management.azure.com/subscriptions/{subId}/resourceGroups\
/my-resource-group/providers/Microsoft.CognitiveServices/accounts\
/my-foundry-account/deployments/model-router-deployment\
?api-version=2025-10-01-preview» \
-H «Content-Type: application/json» \
-H «Authorization: Bearer $AZURE_AI_AUTH_TOKEN» \
-d ‘{
«sku»: {«name»: «GlobalStandard», «capacity»: 10},
«properties»: {
«model»: {«format»: «OpenAI», «name»: «model-router»,
«version»: «2025-11-18»},
«routing»: {
«mode»: «balanced»,
«models»: [
{«format»: «OpenAI», «name»: «gpt-4.1»,
«version»: «2025-04-14»},
{«format»: «OpenAI», «name»: «gpt-5.6-sol»,
«version»: «2026-07-09»},
{«format»: «Meta»,
«name»: «Llama-4-Maverick-17B-128E-Instruct-FP8»,
«version»: «1»}
]
}
}
}’
Tres detalles que la documentación menciona de pasada: los modelos de chat subyacentes no se despliegan por separado (salvo Claude), el filtro de contenido se aplica al router entero y el límite de tokens por minuto cubre toda la actividad del despliegue.
El campo model es tu observabilidad
Desde el código no hay ceremonia: llamas a Chat Completions con el nombre de tu despliegue de router y la respuesta te dice quién ha contestado.
client = AzureOpenAI(
azure_endpoint=endpoint,
api_key=api_key,
api_version=»2024-10-21″,
)
response = client.chat.completions.create(
model=deployment, # nombre de TU despliegue de model router
messages=[
{«role»: «system», «content»: «You are a helpful assistant.»},
{«role»: «user», «content»: «In one sentence, name the most popular »
«tourist destination in Seattle.»},
],
)
print(response.model) # -> modelo subyacente que atendió la petición
En el ejemplo de la documentación para la 2025-11-18 ese campo devuelve gpt-5-mini-2025-08-07, y el bloque usage desglosa además reasoning_tokens y cached_tokens. Ignorarlo figura entre las malas prácticas oficiales. Loguéalo. En Azure Monitor tienes Monitoring > Metrics con split por modelo subyacente; para el dinero, Cost analysis por Tag > Deployment.
Hay además una pieza en preview que conviene conocer: session affinity. Chat Completions es stateless, así que dos turnos de la misma conversación pueden acabar en modelos distintos, lo que tira por tierra el prompt caching. Pasándole un session_id el router intenta mantener el mismo modelo y te dice si la decisión fue initialize, retain o switch. Es best-effort.
La trampa fácil: la ventana de contexto la marca el modelo más pequeño
Si me quedo con una sola advertencia de toda la documentación, es esta: la ventana de contexto efectiva la fija el modelo más pequeño del pool, aunque otros admitan contextos mucho mayores. Una llamada con contexto grande solo funcionará si el prompt cae en el modelo adecuado, cosa que tú no decides.
Las salidas son cuatro: resumir el prompt, truncarlo, mover contexto a embeddings y RAG, o usar el model subset para dejar solo modelos con la ventana que necesitas. La última es la más limpia si tu carga es sistemáticamente de contexto largo. Dos limitaciones más: acepta imágenes, pero enruta solo con el texto. Y de audio, nada.
Una palanca cada vez
La receta oficial para escalar la cuesta es aburrida, que suele ser buena señal. Empieza en Balanced, observa la distribución en Azure Monitor unas semanas y solo después ajusta: batch insensible a latencia a Cost, razonamiento crítico a Quality. Y cambia una palanca cada vez: al tocar routing mode o model subset, mantén fijos dataset, baseline y configuración, y relanza la evaluación.
Tampoco tiene por qué ser todo o nada. El patrón que la documentación recomienda es híbrido: el router para el tráfico general de API y despliegues directos para lo especializado, lo regulado o lo sensible a parámetros. Si necesitas el mismo modelo en cada petición, el router no es tu herramienta.
Lo que más me gusta de esta actualización no es el pool ni el mapa de regiones. Es que el endpoint estable convierte la elección de modelo en algo revisable sin desplegar nada. Y eso cambia la conversación: de «qué modelo elegimos» a «cada cuánto revisamos la elección».
Fuentes
- Model router updates: new regions, a refreshed model pool, and understanding the hill climb (Sanjeev Jagtap, 21/08/2026): https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/model-router-updates-new-regions-a-refreshed-model-pool-and-understanding-the-hi/4521310
- Model router para Foundry Models — concepto, versionado, regiones, cuotas y limitaciones: https://learn.microsoft.com/en-us/azure/foundry/openai/concepts/model-router
- How to use model router — despliegue, REST, código, session affinity y parámetros: https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/model-router
- How model router works — etapas de la decisión, distribución por modo y buenas prácticas: https://learn.microsoft.com/en-us/azure/foundry/openai/concepts/model-router-how-it-works
- Samples oficiales de model router (Python): https://github.com/microsoft-foundry/foundry-samples/tree/main/samples/python/foundry-models/model-router
- Routed Models Distribution Analysis: https://github.com/guygregory/ModelRouter-Distribution
- Auto Evaluation Toolkit, para comparar el router con los modelos base usando tus prompts: https://aka.ms/modelrouter/evaluations